查得到,也要搬得走:Zvec 全量遍历的设计与实现
Zvec v0.7.0 引入 DocIterator:流式读出整个集合。迭代器在创建时定格一份隔离视图,遍历期间可进行查询、写入和删除,且不影响一致性;文档按窗口物化,内存开销与集合的大小无关;可以只取部分字段、跳过向量。提供多种编程语言的 SDK 接口。Zvec Studio 则把它包装成界面化的数据导出,并配套了导入与整库迁移。
在 Zvec 中,可以利用向量高效检索相似数据,也可以结合标量条件过滤结果,但如果要将已经存入的数据完整导出,应该怎么做?
在 v0.7.0 之前,Zvec 缺少全量遍历接口,fetch()/query()这类检索接口也无法保证覆盖整个集合。新增的 DocIterator 补齐了这一能力,它面向的是与“检索”不同的另一类需求:不关心相似度、不关心排序,只要求完整、稳定、低开销地把每条数据读出来。这类需求在实际使用中并不少见:
- 几台机器分别跑完 embedding,要把结果合并成一个集合;
- 给 Agent 的长期记忆做离线整理、去重、重新分片;
- 导出一份数据集,交给别的语言、别的工具处理;
- 迁移或备份,在另一台机器上原样重建一个集合。
本文讲清楚三件事:为什么原有接口行不通、DocIterator 怎么用、以及它内部是怎么在“恒定内存”和“一致视图”之间做设计取舍的。
一、为什么原有接口行不通
在有 DocIterator 之前,想遍历整个集合,有三条看起来可行的路。它们各自卡在不同的地方,而这些卡点恰好解释了为什么遍历需要一个专门的接口。
路一:按主键批量 fetch()。 fetch() 一次能取多条、也能裁剪字段,看起来够用——但它按主键取,而你得先有一份全部主键的清单。Zvec 没有“列出所有主键”的接口,因为那本身就是一次全量遍历,这是先有鸡还是先有蛋的问题。
路二:把 topk 调大,一次全查回来。 query() 的语义是返回最相似的 k 条,topk 有上限(当前为 10 万)。拿它做全量导出有两个硬伤:你手里根本没有一个查询向量,只能凭空造一个;而且集合超过 10 万条就查不全。
路三:绕过接口,直接拷贝数据文件。 这条路最诱人也最危险——因为 Zvec 的内部存储不是、也不该是导出格式:
| 障碍 | 具体是什么 |
|---|---|
| 向量和标量分开存 | 标量在正排文件里,向量在各自的索引文件里,拷正排文件拿不到向量 |
| 正排里混着系统列 | 除了用户字段,还有 _zvec_g_doc_id_、_zvec_row_id_ 这类内部行号列 |
| 有一部分数据还没落盘 | 正在写入的段数据在内存里,文件层面根本看不到 |
| 文件布局不固定 | 一个段对应多个文件,且格式随存储配置在 Arrow IPC 与 Parquet 之间变化 |
这三条路的共同结论是:“读出用户当初写进去的那条文档”这件事,只有引擎能做。它知道 schema、知道当前有哪些段、哪些行已被删除、某个行号该去哪个索引文件取向量——这些信息应用层拿不全,也不该去拼。DocIterator 就是把这件事做成了一个正式接口。
三种查询方式各有各的定位,不是谁替代谁:
query() | fetch() | iter_docs() | |
|---|---|---|---|
| 用途 | 查最相似 | 按主键取 | 读整个集合 |
| 需要查询向量 | 需要 | 不需要 | 不需要 |
| 能否覆盖整个集合 | 上限 10 万条 | 需先有全部主键 | 可以 |
| 单次内存 | 至多 topk 条 | 所请求的全部文档 | 一个窗口,流式 |
| 一致性范围 | 单次调用内 | 单次调用内 | 整个遍历过程 |
二、DocIterator能做什么
最直接的印象来自代码。遍历一个集合、导出成 JSON Lines,就是一个循环:
import json

with collection.iter_docs() as docs:
    for doc in docs:
        line = {"id": doc.id, "fields": doc.fields, "vector": doc.vector("embedding")}
        print(json.dumps(line))
doc.id 是主键,doc.fields 是标量字段字典,doc.vector(name) 取某个向量字段(示例里的 embedding 是向量字段名)。读到末尾循环自然结束。这段代码无论集合里是几千条还是几千万条,内存占用都在同一量级——这是 DocIterator 最核心的性质,后面第三节会讲它是怎么做到的。
它给出三个保证,正好对应遍历这件事最容易出问题的三个点:
读得全,且不需要查询向量。 iter_docs() 把每条文档依次交出来(遍历顺序不作保证),回答的是“集合里都有什么”,而不是“什么最相似”。
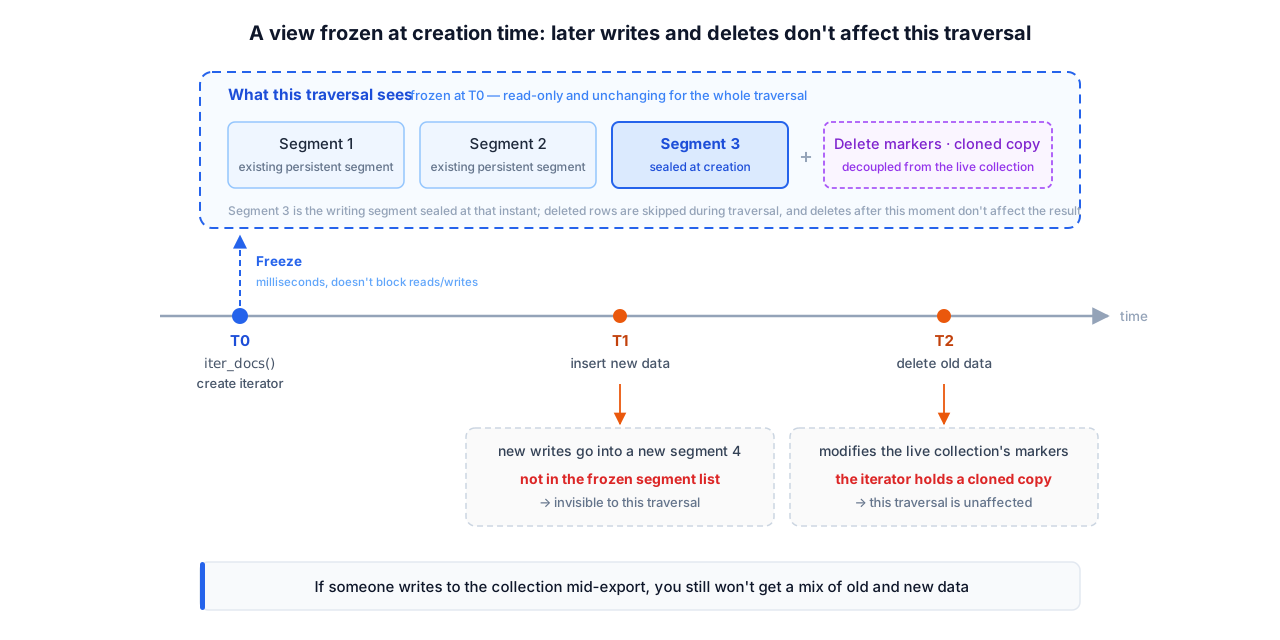
读得稳:创建时定格一份视图。 迭代器创建的那一刻,当时正在写入的数据被一并纳入,删除标记被单独复制一份。此后无论集合里发生什么写入和删除,本次遍历看到的都是创建那一刻的样子。导出过程中即使发生写入集合的操作,也不会得到一份新旧混杂的数据。
读得省:内存与集合的大小无关。 文档按窗口物化、一条一条地交出来,整个窗口在物化下一窗口前释放。
在这三个保证之上还可以裁剪——只取需要的标量字段,或者不要向量:
with collection.iter_docs(
    output_fields=["title", "score"],  # 只取这些标量字段;主键始终返回
    include_vector=False,              # 默认 True;不需要向量时关掉更快
) as docs:
    for doc in docs:
        ...
裁剪不只是省字段,也直接影响速度。同一份 100 万条 256 维的集合,完整遍历一遍:
| 耗时 | 吞吐 | |
|---|---|---|
include_vector=True(默认) | 4.06 s | 25 万条/秒 |
include_vector=False | 1.03 s | 97 万条/秒 |
差距来自向量:向量不在正排文件里,取向量意味着为每条文档额外去向量索引读一次。导出场景里如果向量不是必需的(比如只想核对标量字段、统计分布),关掉它能快四倍。
三、内部设计:在一致和省内存之间取舍
遍历整个集合看似简单,真正要解决的是一对矛盾:既要让这次遍历看到一份自洽的数据(否则导出的集合是坏的),又不能为此把整个集合读进内存(否则大集合直接 OOM)。DocIterator 的设计就是围绕这对矛盾展开的。
3.1 一致性:定格,而不是加锁
最简单的一致是加一把大锁——遍历期间禁止一切写入。但全量导出可能持续几分钟到几小时,锁住整个集合显然不可接受。
Zvec 的选择是在创建时定格一份视图,之后遍历不再需要和写入争抢。create_iterator() 在创建那一刻做四件事:
- 若当前存在正在写入且非空的段,将其封存成一个不可变的持久段;
- 取此刻的持久段列表;
- 深拷贝一份删除标记;
- 记下当前 schema。
这一切在一把短暂的写锁内完成,只占用毫秒级时间。此后:新写入进入一个新的段,不在已定格的段列表里,遍历看不到;新的删除改的是原集合的标记,而迭代器手里是自己那份克隆副本,不受影响。
一个实现上的细节值得一提:字段合法性校验被刻意放在封存之前。如果用户传了不存在的字段名,接口直接报错返回,不会留下一个白白封存的段。
需要说明的是,这不是 MVCC。Zvec 没有多版本存储,也不提供“回到任意历史时间点”的能力——它给的是一次性定格的隔离视图,足以保证单次导出的数据自洽,但不承诺你三天后还能读回今天的状态。对导出、备份、迁移这些场景,这个保证刚好够用,也足够轻量。
只读集合走更简单的路:不封存、不写盘(写盘违反只读语义),直接把包括正在写入段在内的所有段纳入遍历——只读集合本就没有并发写入,视图天然稳定。
3.2 省内存:三层惰性 + 窗口物化
定格解决了一致,但它定格的是段的列表,不是段里的数据——数据仍然是边遍历边读的。这里 DocIterator 做了三个层次的“不多拿”:
- 段级:同一时刻只打开一个段的读取器,这个段读完就关掉,再打开下一个。任意时刻最多只有一个段的文件被打开;
- 列级:从一个段读上来的一批数据是 Arrow 列式格式,转成 Document 时按列处理,比逐行更高效;向量不在正排里,需要时再按段内行号去向量索引取;
- 窗口级:把一批数据转成 Document 时,以窗口为单位,一个窗口最多 4096 行(
kMaxRecordBatchNumRows),这一窗交给用户、释放,再转下一窗。
所以任意时刻真正物化成 Document 的只有一个窗口,迭代器自身的内存开销是常数级,不随集合的大小增长。100 万条 256 维的集合,只取标量字段完整遍历一遍,内存增量全程是一条平线(实测稳定在 1.3 MB,与已读 20 万还是 100 万无关)。
如果连向量一起取,你会在监控里看到 RSS 随遍历一路爬升,这并不与前面矛盾,而是两层不同的内存:迭代器在堆上物化的 Document 始终只有一个窗口;而向量存在向量索引文件里、默认以内存映射(mmap)方式访问,遍历逐条读向量会依次触达它们所在的页,这些页作为文件缓存留在 RSS 里。它由操作系统管理、内存紧张时可回收,不是迭代器在堆上攒数据。
一句话:省内存指的是迭代器自身的常驻开销恒定在一个窗口。 带向量的全量导出终究要把每条向量都读一遍,这部分是数据本身的体量、与用哪个接口无关;只导出标量时用 include_vector=False,就回到那条平线。
3.3 遍历期间,集合还能不能用
定格保证了遍历不受写入干扰,反过来,遍历会不会拖住别的操作?答案是分两类:
| 遍历打开期间的操作 | 行为 |
|---|---|
| insert / upsert / update / delete | ✅ 正常(新写入对本次遍历不可见) |
| query / fetch / stats | ✅ 正常 |
| flush | ✅ 正常 |
| create_index / drop_index add_column / alter_column / drop_column | ❌ 立即报错 |
| optimize | ❌ 立即报错 |
| destroy / close | ❌ 立即报错 |
| 再创建一个迭代器 | ✅ 允许,多个迭代器可并存 |
一句话概括:写入和查询完全不受影响,只有会改变集合结构的维护类操作(改 schema、优化、销毁)会被挡住。 反过来也一样——当一个维护操作正在进行时,create_iterator() 会立即报错而不是排队等待。
这里用“立即报错”而不是“阻塞等待”是有意为之:一个遍历可能开着几分钟,如果让 DDL 去等它,就等于让维护操作被一个不知何时结束的遍历无限期挂住。立即失败不改变任何状态,调用方关掉迭代器重试即可——这也是为什么在 Python 里推荐用 with:它保证遍历在正常结束、提前 break、中途异常等任何路径下都被及时关闭,不会因为忘记关闭而长时间挡住维护操作。
四、SDK调用方法
DocIterator 在多种语言提供一致的语义。
Python 最简洁,iter_docs() 返回的对象既是迭代器又是上下文管理器:
# 直接遍历
for doc in collection.iter_docs():
    process(doc.id, doc.fields, doc.vector("embedding"))

# 提前结束用 with,保证及时释放
with collection.iter_docs(include_vector=False) as docs:
    for doc in docs:
        if enough(doc):
break合并多个集合是个典型组合——读取侧流式、写入侧分批(单次写入上限 1024 条):
from itertools import islice

with src.iter_docs() as docs:
    for batch in iter(lambda: list(islice(docs, 1000)), []):
        target.insert(batch)
C++ 的 next() 是三态返回,出错和“读完了”分得清清楚楚:
IteratorOptions options;
options.output_fields_ = {"title", "score"};
options.include_vector_ = false;

auto it = collection->create_iterator(options).value();
while (true) {
  auto r = it->next();
  if (!r.has_value()) {             // 出错:r.error() 是具体原因,必须处理
    std::cerr << r.error().message() << std::endl;
    return 1;
  }
  if (r.value() == nullptr) break;  // 遍历结束
  const Doc::Ptr &doc = r.value();
  // doc->pk()、doc->get<std::string>("title");include_vector_=false,故文档中不含向量
}
it->close();  // 提前结束时显式释放;离开作用域也会自动释放
出错时显式返回错误而不是静默跳过,这一点对全量遍历尤其重要:一次遍历可能涉及几千万条数据,静默跳过意味着你拿到一份不完整的数据却毫不知情。
C API 对应 zvec_collection_create_iterator() / zvec_doc_iterator_next() / zvec_doc_iterator_close(),语义完全一致。
对于 Node.js 等语言调用方法可参考官方API文档 https://zvec.org/en/api-reference/。
五、Zvec Studio:把遍历变成界面操作
命令行之外,Zvec Studio(Zvec 的桌面管理工具)在 DocIterator 之上做了图形化的数据导出,并配套了导入与整库迁移。进入任意集合,切到导入/导出标签页即可。
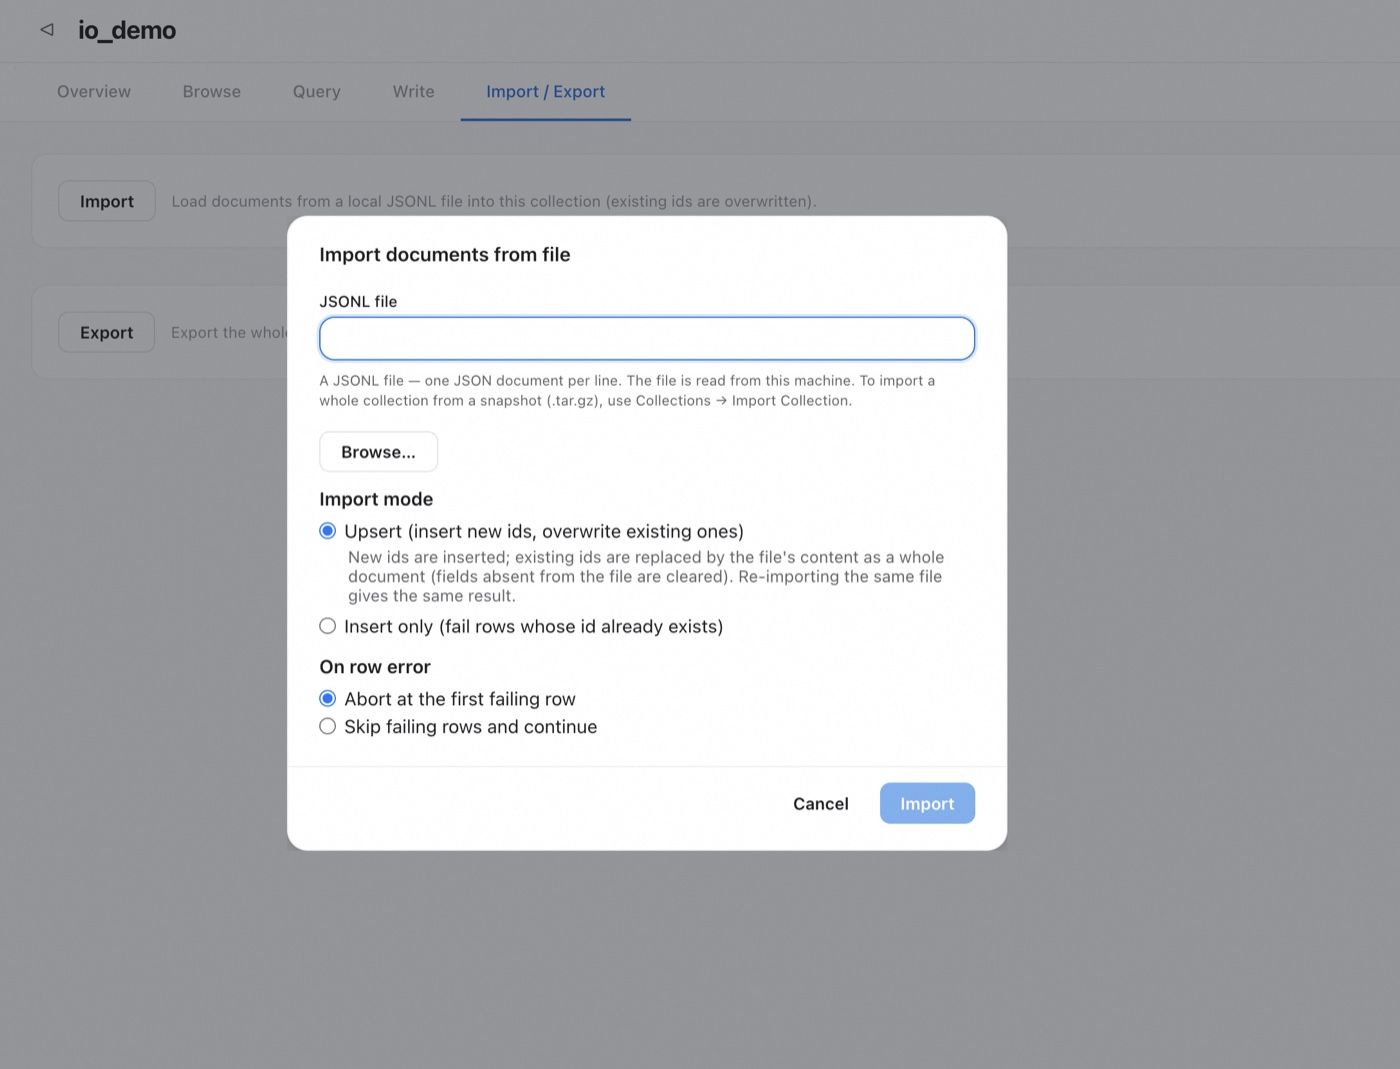
导入:读取本地 JSONL 分批写入,返回逐行报告。两种模式(更新 更新同主键 / 仅新增 只写新主键),两种错误策略:
skip:跳过坏行继续,成功数 + 失败数 = 总行数,一条坏行不会拖垮整批导入;abort:遇到第一条失败行就停,并且已写入的行会被撤回,不会留下一个“导了一半”的集合。
导出:整个集合以 JSON Lines 流式下载,文件名自带时间戳。可以选择是否包含向量、是否包含标量字段、以及只导出指定字段。导出全程流式,导出的数据量不影响内存占用。
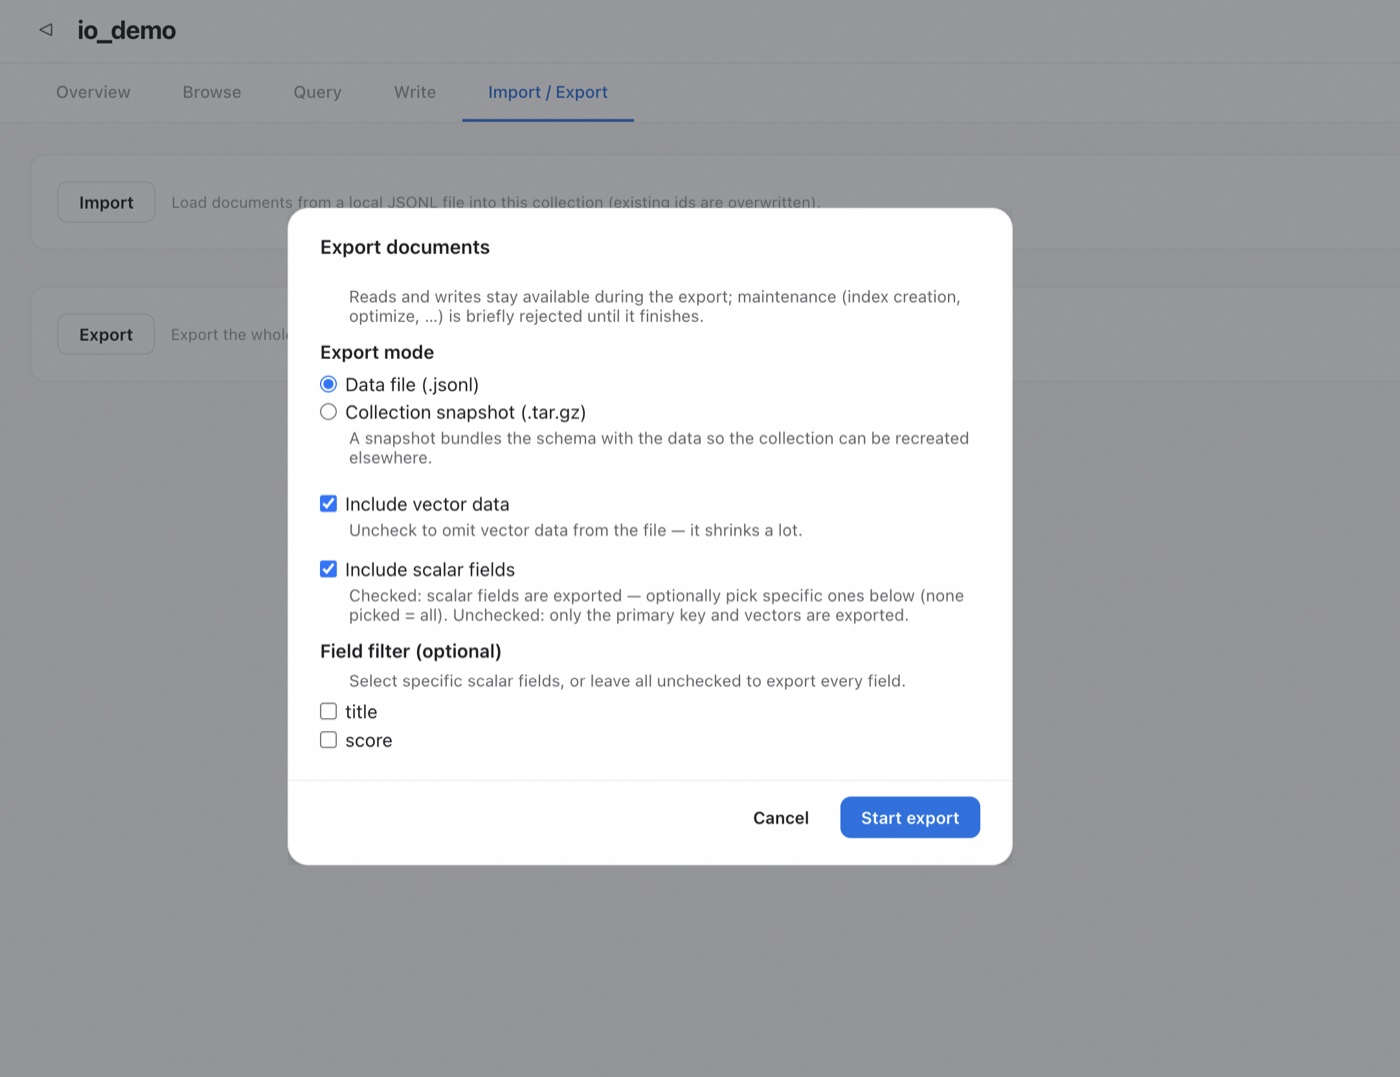
整库迁移:导出时选择快照模式,会把完整 schema 和数据一起打包成 .tar.gz。在另一台机器上导入集合即可重建整个集合——写入前先做 schema 预检(不匹配会列出差异并拒绝),支持重命名,并且全成或全败:中途出错或任一行失败,新建的集合会被回滚,并指出第一条出错的行。
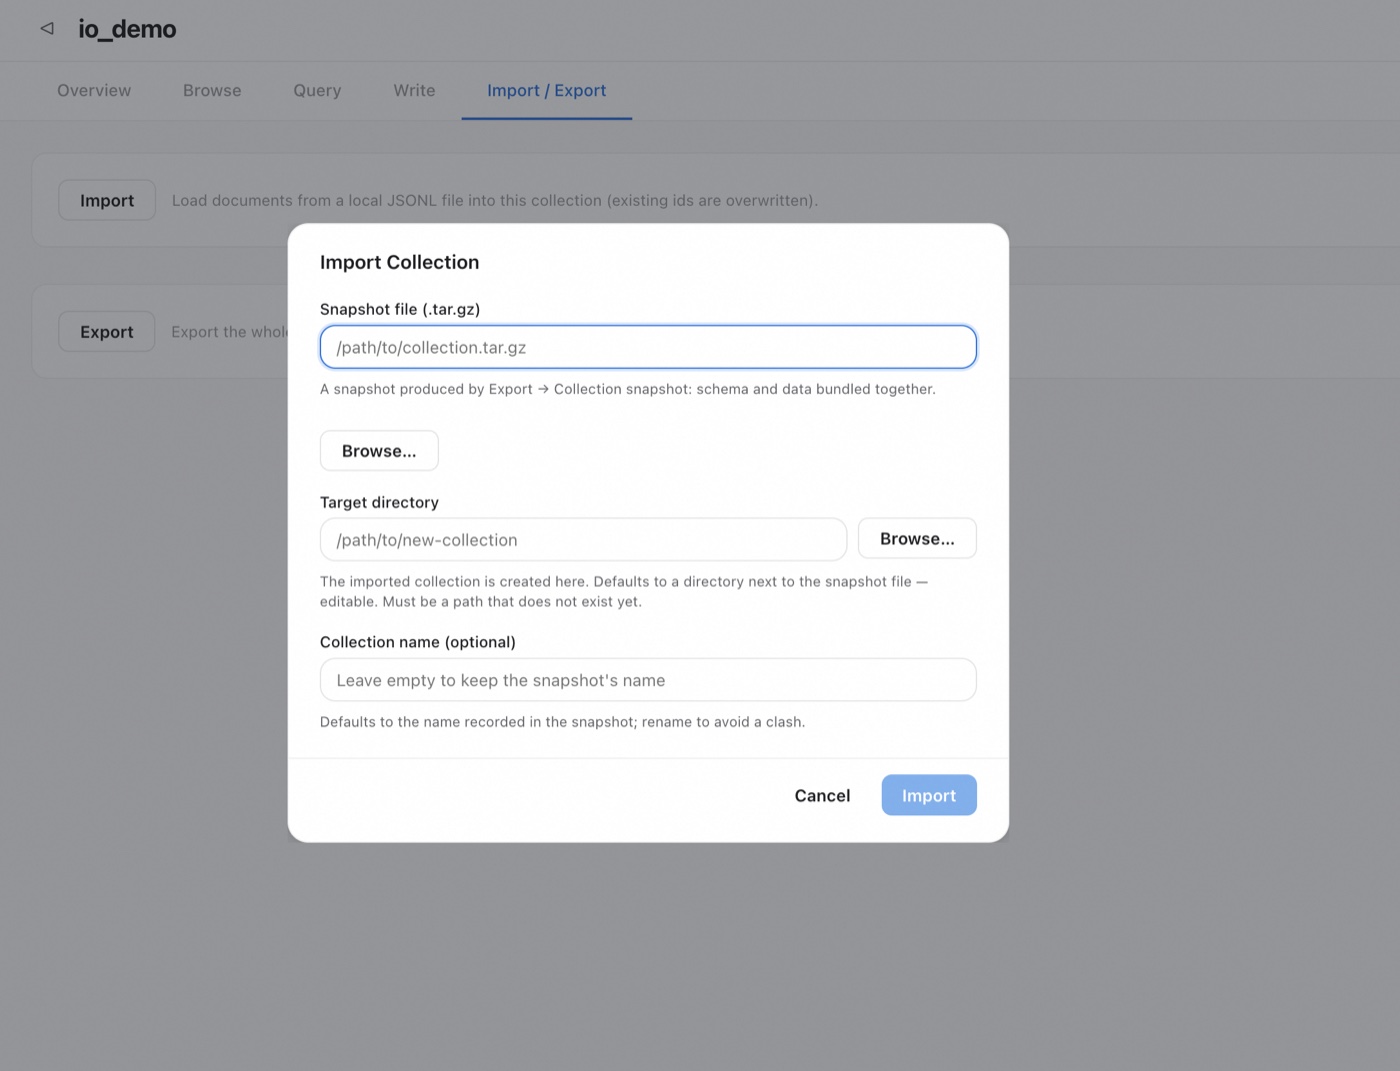
开头那几个场景到这里就都能落地了:每台机器各自导出快照,拷到一起逐个重建;或者先把 JSONL 合并,再一次性导入。这些能力同样有对应的 HTTP 接口,便于接进自动化流程。
六、边界与注意事项
- 一致性是一次性定格,不是 MVCC:适合一次完整的导出/备份/迁移,不能当作可回溯的历史版本;
- 遍历与维护操作互斥:迭代器打开期间,改 schema、optimize、destroy、close 会报错。长时间挂着的迭代器会挡住这些操作,用完记得关(Python 用
with最稳妥); - 可写集合上创建迭代器可能封存一个段:频繁创建迭代器会积累出许多小段,需要时用
optimize()合并; - 导出格式目前是 JSON Lines:其他格式(如直接产出 Parquet)尚未提供。
七、小结
向量数据库的价值不只在于查得准,也在于数据“进得来、出得去”。Zvec v0.7.0 的 DocIterator 把“完整读出一个集合”做成了一个语义清晰的引擎接口:
- 读得全——覆盖整个集合,按需导出向量,不漏一条数据;
- 读得稳——创建时定格隔离视图,遍历过程数据自洽,而代价只是毫秒级的封存,不阻塞并发读写;
- 读得省——三层惰性 + 窗口物化,峰值内存与集合大小无关。
Zvec Studio 在此之上把导出做成了界面,并配套了导入与整库迁移,让“搬数据”这件事对命令行用户和图形界面用户都顺手。
如果你的数据正卡在“查得到但搬不走”,升级到 v0.7.0,用 iter_docs();偏好图形界面,直接用 Studio 的导入/导出。
Zvec 以 Apache 2.0 协议开源,欢迎体验、反馈与贡献。